uniCloud提供了一个 JSON 格式的文档型数据库。顾名思义,数据库中的每条记录都是一个 JSON 格式的文档。
它是 nosql 非关系型数据库,如果您之前熟悉 sql 关系型数据库,那么两者概念对应关系如下表:
| 关系型 | JSON 文档型 |
|---|---|
| 数据库 database | 数据库 database |
| 表 table | 集合 collection。但行业里也经常称之为“表”。无需特意区分 |
| 行 row | 记录 record / doc |
| 字段 column / field | 字段 field |
| 使用sql语法操作 | 使用MongoDB语法或jql语法操作 |
uniCloud服务空间,有且只有一个数据库;例如,数据库中有一个表,名为user,存放用户信息。表user的数据内容如下:
{"name":"张三","tel":"13900000000"}
{"name":"李四","tel":"13911111111"}
上述数据中,每行数据表示一个用户的信息,被称之为“记录(record/doc)”。name和tel称之为“字段(field)”。而“13900000000”则是第一条记录的字段tel的值。
每行记录,都是一个完整的json文档,获取到记录后可以使用常规json方式操作。但表并非json文档,表是多个json文档的汇总,获取表需要使用专门的API。
与关系型数据库的二维表格式不同,json文档数据库支持不同记录拥有不同的字段、支持多层嵌套数据。
仍然以user表举例,要在数据库中存储每个人的每次登录时间和登录ip,则变成如下:
{
	"name":"张三","tel":"13900000000",
	"login_log":[
		{"login_date":1604186605445,"login_ip":"192.168.1.1"},
		{"login_date":1604186694137,"login_ip":"192.168.1.2"}
	]
}
{"name":"李四","tel":"13911111111"}
上述数据表示张三登录了2次,login_date里的值是时间戳(timestamp)格式,在数据库内timestamp就是一个数字类型的数据。而李四没有登录过。
可以看出json文档数据库相对于关系型数据库的灵活,李四可以没有login_log字段,也可以有这个字段但登录次数记录与张三不同。
此处仅为举例,实际业务中,登录日志单独存放在另一个表更合适
对于初学者,如果不了解数据库设计,可以参考opendb,已经预置了大量常见的数据库设计。
对于不熟悉传统数据库,但掌握json的js工程师而言,uniCloud的云数据库更亲切,没有传统数据库高昂的学习成本。
在uniCloud web控制台新建表时,在下面的模板中也可以选择各种opendb表模板,直接创建。
uniCloud同时支持阿里云、腾讯云和支付宝云,它们的数据库大体相同,有细微差异。阿里云和支付宝云的数据库是mongoDB4.2,腾讯云则使用自研的文档型数据库(兼容mongoDB 4.0版本)。uniCloud基本抹平了不同云厂商的差异,有差异的部分会在文档中单独标注。
打开 uniCloud web控制台 https://unicloud.dcloud.net.cn/
创建或进入一个已存在的服务空间,选择 云数据库->云数据库,创建一个新表
比如我们创建一个简历表,名为 resume。点击上方右侧的 创建 按钮即可。
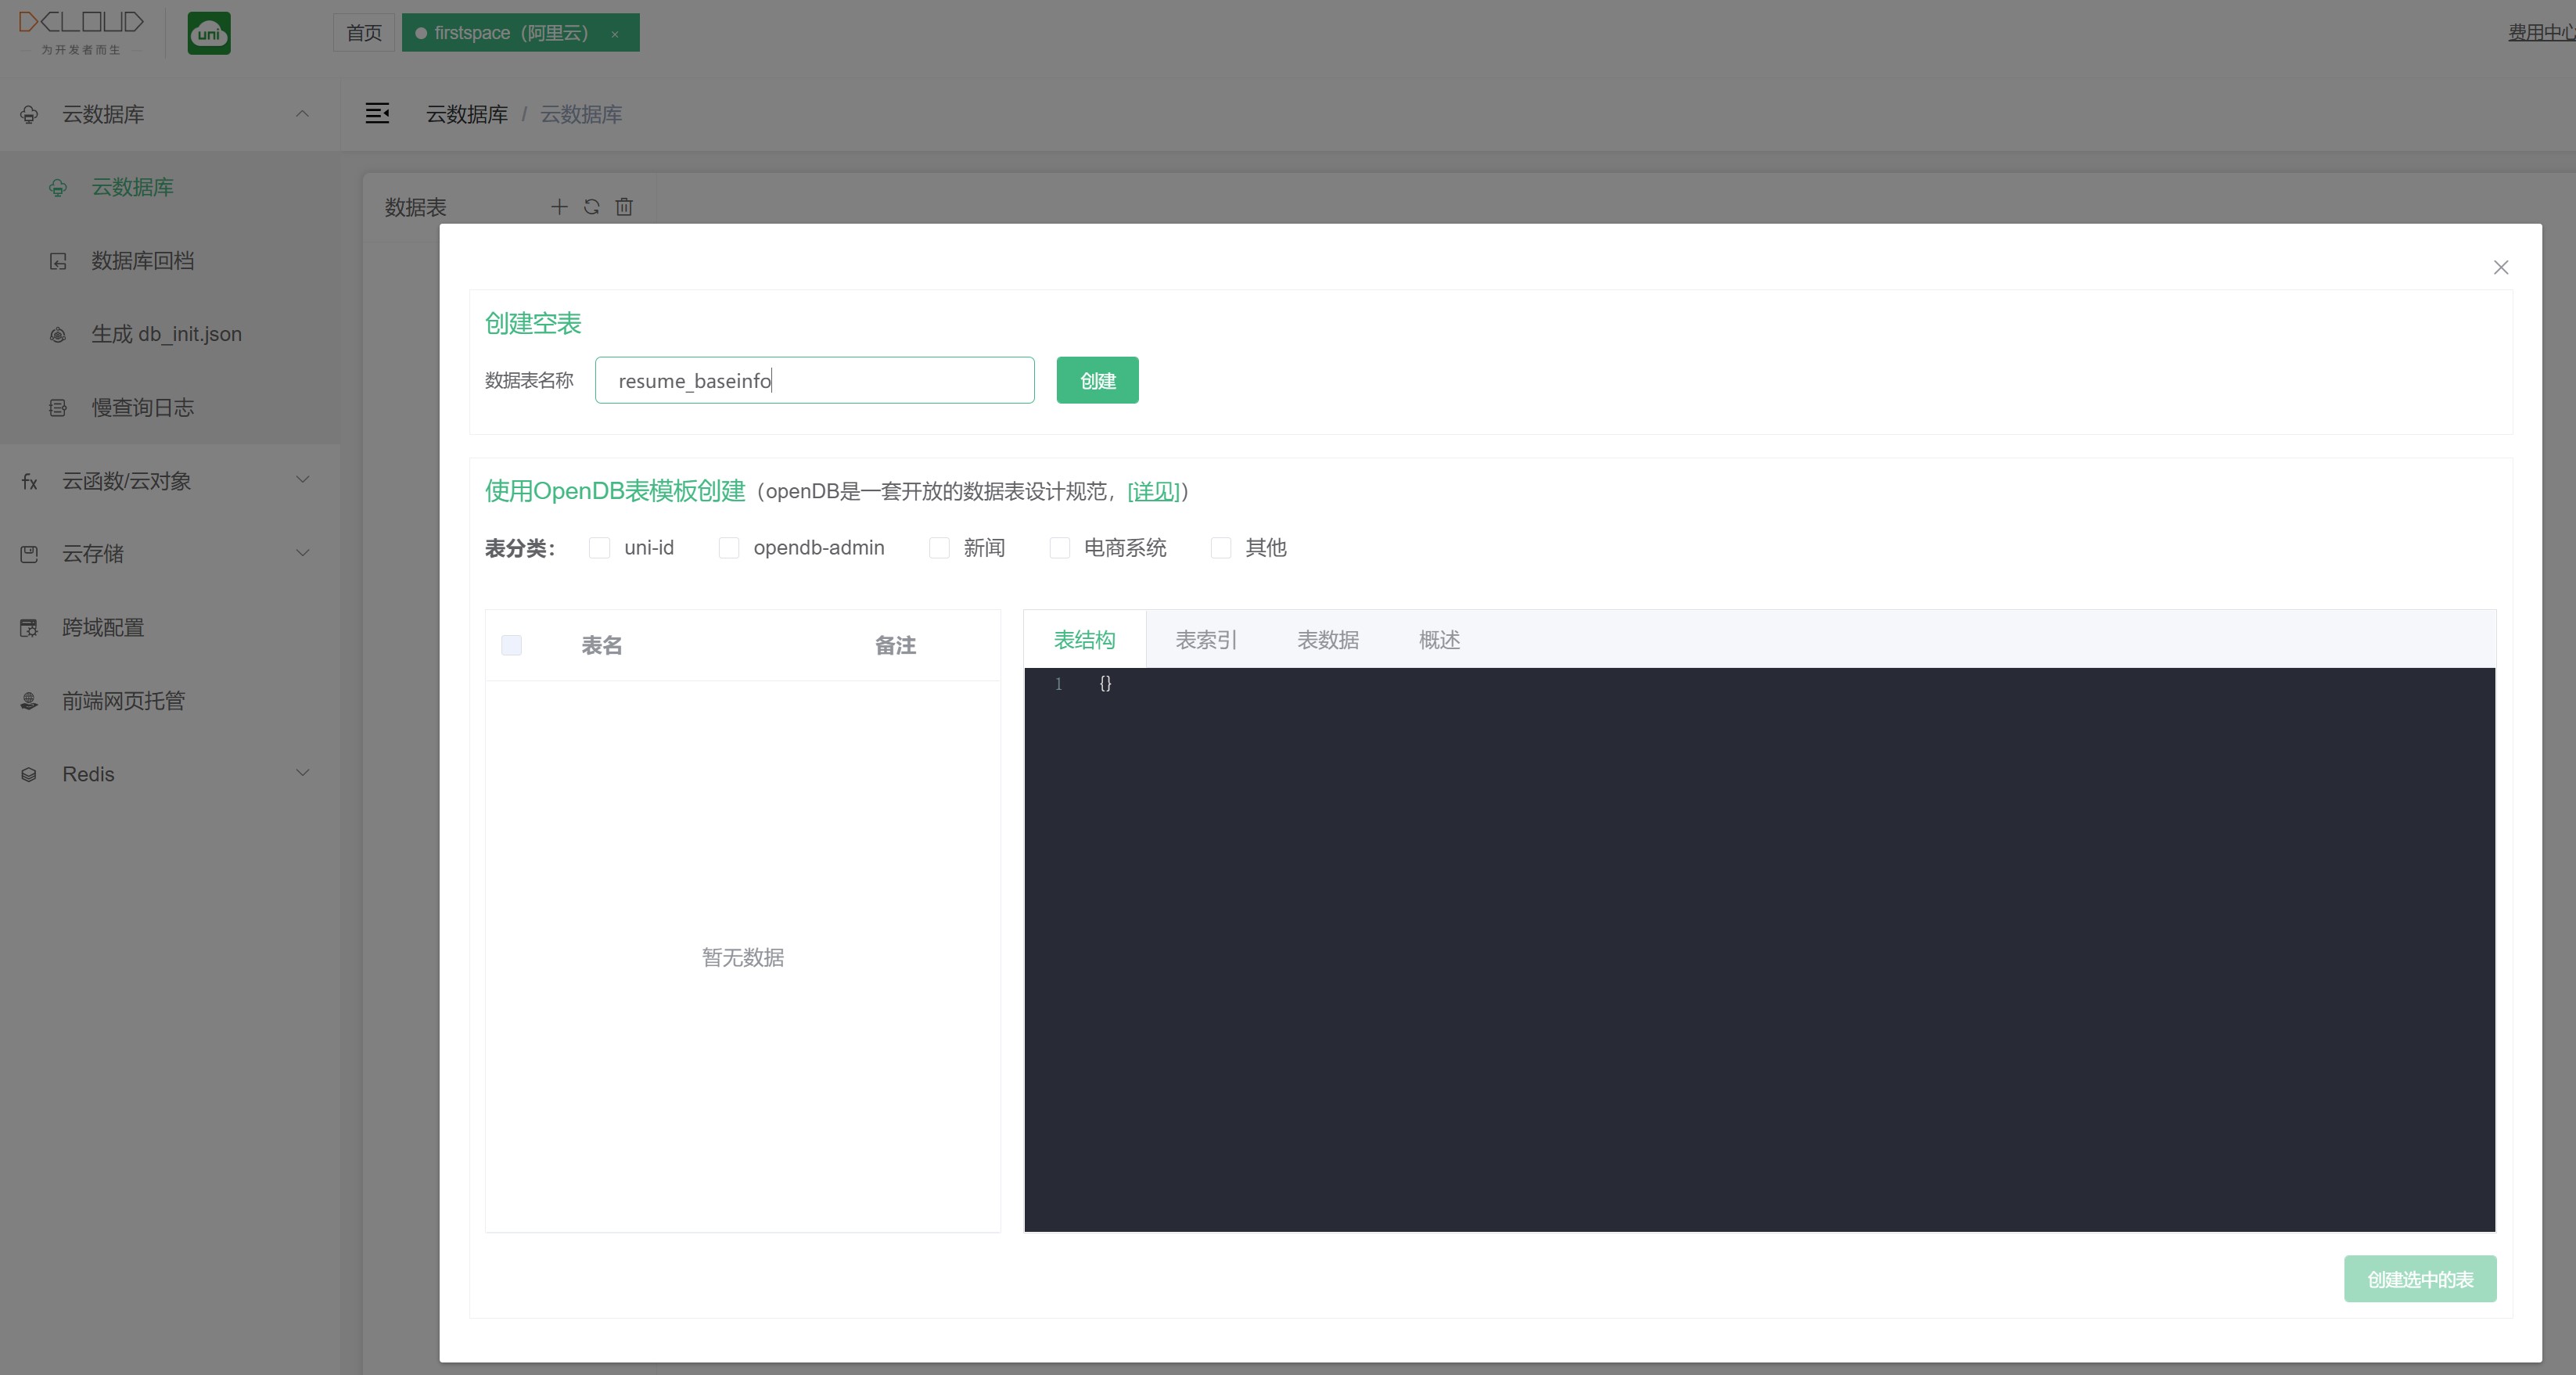
新建表时,支持选择现成的 opendb 表模板,选择一个或多个模板表,可以点击右下方按钮创建。
创建表一共有3种方式:
每个数据表,包含3个部分:
在uniCloud的web控制台可以看到一个数据表的3部分内容。
data,就是存放的数据记录(record)。里面是一条一条的json文档。
record可以增删改查、排序统计。后续有API介绍。
可以先在 web控制台 为之前的 resume 表创建一条记录。
输入一个json
{
    "name": "张三",
    "birth_year": 2000,
    "tel": "13900000000",
    "email": "zhangsan@zhangsan.com",
    "intro": "擅于学习,做事严谨"
}
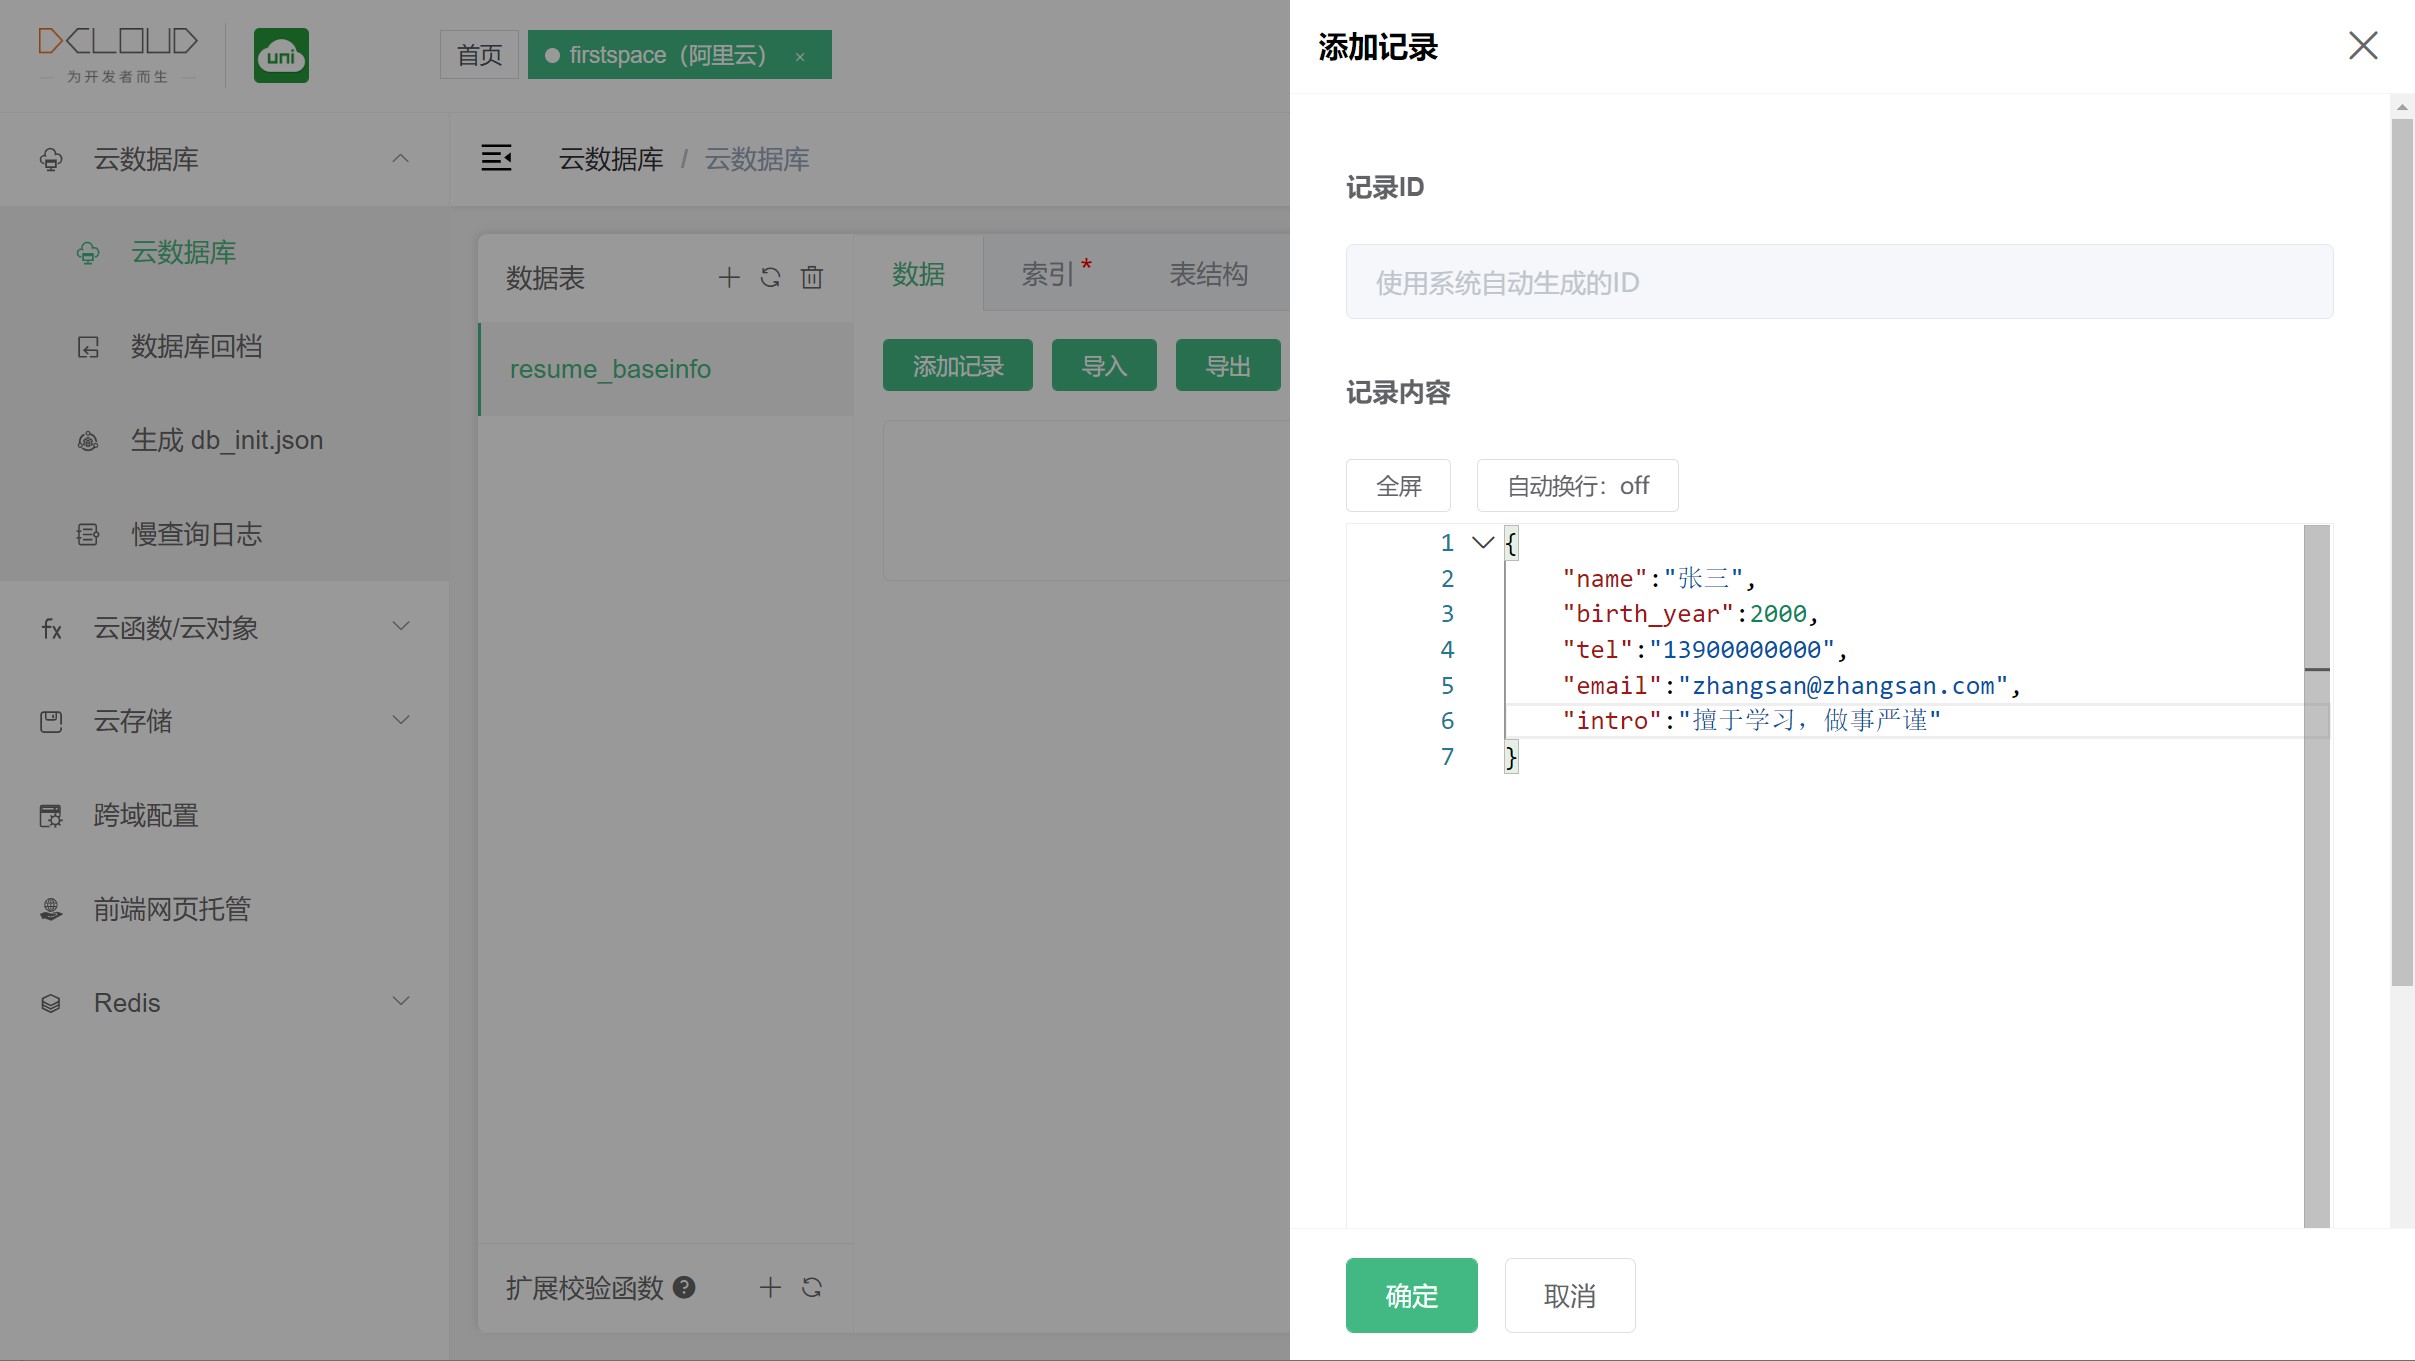
创建一条新记录,是不管在web控制台创建,还是通过API创建,每条记录都会自带一个_id字段用以作为该记录的唯一标志。
_id字段是每个数据表默认自带且不可删除的字段。同时,它也是数据表的索引。
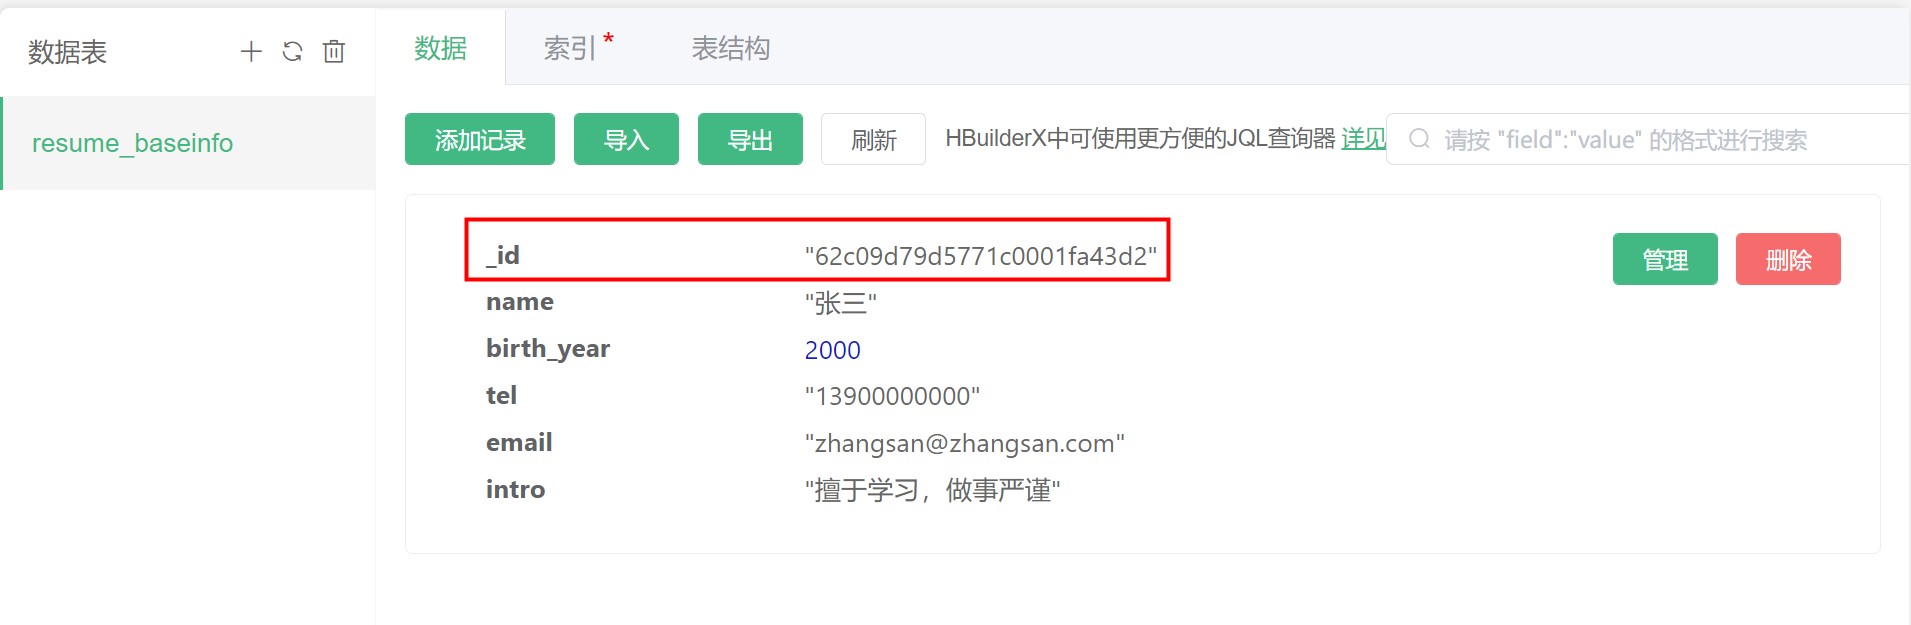
阿里云使用的是标准的mongoDB,_id是自增的,后创建的记录的_id总是大于先生成的_id。传统数据库的自然数自增字段在多物理机的大型数据库下很难保持同步,大型数据库均使用_id这种长度较长、不会重复且仍然保持自增规律的方式。
腾讯云使用的是兼容mongoDB的自研数据库,_id并非自增
插入/导入数据时也可以自行指定_id而不使用自动生成的_id,这样可以很方便的将其他数据库的数据迁移到uniCloud云数据库。
所谓索引,是指在数据表的众多字段中挑选一个或多个字段,让数据库引擎优先处理这些字段。
设置为索引的字段,在通过该字段查询(where)或排序(orderBy)时可以获得更快的查询速度。
但设置过多索引也不合适,会造成数据新增和删除变慢。
新建的表,默认只有一个索引_id。
一个数据表可以有多个字段被设为索引。
索引分唯一型和非唯一型。
唯一型索引要求整个数据表多个记录的该字段的值不能重复。比如_id就是唯一型索引。
假使有2个人都叫“张三”,那么他们在user数据表里的区分就是依靠不同的_id来区分。
如果我们要根据name字段来查询,为了提升查询速度,此时可以把name字段设为非唯一索引。
索引内容较多,还有“组合索引”、“稀疏索引”、“地理位置索引”、“TTL索引”等概念。有单独的文档详细讲述索引,另见:数据库索引
在web控制台添加上述索引
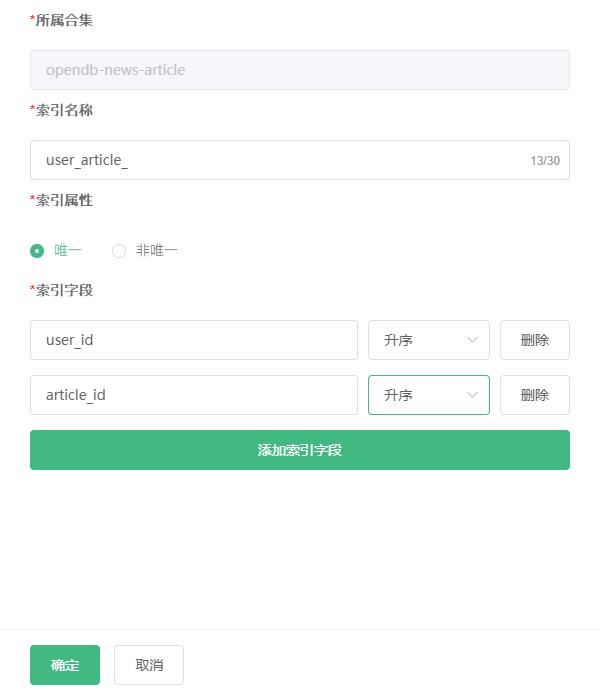
注意
DB Schema是表结构描述。描述数据表有哪些字段、值域类型是什么、是否必填、数据操作权限等很多内容。
因为 MongoDB 的灵活性,理论上DB Schema不是必须的,使用传统 MongoDB API 操作数据库不需要DB Schema。
但如果使用 JQL,那DB Schema就是必须的。
DB Schema涉及内容较多,另见文档:https://uniapp.dcloud.io/uniCloud/schema
uniCloud 的云数据库有多种操作方式。
uniCloud 默认推荐使用 JQL 语法操作数据库,它是一种更简单易用、对js开发者更友好的、开发效率更高的数据库操作语法。详见
不管在云函数中还是在uni-app客户端中,均支持JQL。
同时 uniCloud 保留了在云函数中使用传统 MongoDB 的 nodejs API 操作云数据库。
| 运行在云端 | 运行在客户端 | 支持 DB Schema | |
|---|---|---|---|
| JQL云函数 | √ | √ | √ |
| 传统MongoDB客户端 | √ | X | X |
关于几种操作数据库方式的选择:
优先使用客户端操作数据库(称为clientDB)
传统开发中,其实大多数服务器接口开发,就是检验下前端数据和身份的合法性,然后写个SQL操作下数据库,返回JSON给前端。其实很无聊。
clientDB最大的好处就是不用写服务端代码,客户端直接操作数据库。因为uniCloud提供了DB Schema和uni-id,可以直接控制数据库的内容和权限校验。
clientDB同时支持action云函数作为补充,当发起一个客户端操作云数据库的请求时,可以同时触发一个action云函数,在云端对数据库操作进行前置或后置处理。
如下场景不适用clientDB:
其次使用云函数的JQL扩展库来操作数据库
对于clientDB不适应的场景,推荐在云函数或云对象中使用JQL。
目前云函数中JQL不适用的场景:使用 set 操作符动态修改字段名称(不是字段值)。这个场景常规业务不涉及,未来JQL可能会完善并支持这个场景。
除非开发者原本就对 nodejs 操作 MongoDB 非常熟悉,且需要使用 set 操作符动态修改字段名等,否则不推荐使用传统MongoDB写法。
MongoDB API操作数据库,不能在客户端操作、不支持 DB Schema,不支持HBuilderX的jql查询器,不能在客户端的代码提示中提示数据库的表名、字段。
不管使用哪种方法,都有很多公共的概念或功能。本文档将讲述这些公共的内容。
同时左侧导航有三种方法的专项链接,描述它们各自特有的功能。
想要通过代码操作数据库,第一步要获取服务空间里的数据库对象。
const db = uniCloud.database(); //代码块为cdb
js中敲下代码块cdb,即可快速输入上述代码。
其中,云函数内使用JQL扩展库时,还需要做一个工作,就是指定操作用户身份。详见
// 云函数中JQL使用示例
'use strict';
exports.main = async (event, context) => {
	const dbJQL = uniCloud.databaseForJQL({ // 获取JQL database引用,此处需要传入云函数的event和context,必传
		event,
		context
	})
	return {
		dbJQL.collection('book').get() // 直接执行数据库操作
	}
};
如果当前应用仅使用一个服务空间,在HBuilderX中做好服务空间关联即可。获取当前空间的数据库实例时无需传递配置,直接调用database方法默认就是操作关联服务空间的数据库。
如果应用有连接其他服务空间数据库的需求,可以在获取database实例时传递对应服务空间的配置
HBuilderX 3.2.11及更高版本支持客户端初始化其他服务空间database实例,此前仅腾讯云云函数环境支持。阿里云云函数环境不支持此用法。
调用uniCloud.database()时可以传入对应的服务空间信息(参数同uniCloud.init,参考:uniCloud.init)来获取指定服务空间的database实例。
注意
示例
const db = uniCloud.database({
  provider: 'tencent',
  spaceId: 'xxx'
})

db.collection('uni-id-users').get()
参数说明
| 参数名 | 类型 | 必填 | 默认值 | 说明 |
|---|---|---|---|---|
| provider | String | 是 | - | aliyun、tencent |
| spaceId | String | 是 | - | 服务空间ID,注意是服务空间ID,不是服务空间名称 |
| clientSecret | String | 是 | - | 仅阿里云支持,可以在uniCloud控制台服务空间列表中查看 |
| endpoint | String | 否 | https://api.bspapp.com | 服务空间地址,仅阿里云支持。阿里云正式版需将此值设为https://api.next.bspapp.com |
| timeout | Number | 否 | 5000 | 仅支付宝云支持,请求超时时间(单位:毫秒),默认为5秒。 |
调用add方法,给某数据表新增数据记录时,如果该数据表不存在,会自动创建该数据表。如下代码给table1数据表新增了一条数据,如果table1不存在,会自动创建。
const db = uniCloud.database();
db.collection("table1").add({name: 'Ben'})
腾讯云提供了专门的创建数据表的API,此API仅支持云函数内运行,不支持clientDB调用。
const db = uniCloud.database();
db.createCollection("table1")
支付宝云提供了专门的创建数据表的API,此API仅支持云函数内运行,不支持clientDB调用。
const db = uniCloud.database();
db.createCollection("table1")
注意
创建好数据表后,可以通过API获取数据表对象。
const db = uniCloud.database();
// 获取名为 `table1` 数据表的引用
const resume = db.collection('resume');
集合/数据表 Collection 的方法
通过 db.collection(name) 可以获取指定数据表的引用,在数据表上可以进行以下操作
| 类型 | 接口 | 说明 |
|---|---|---|
| 写 | add | 新增记录(触发请求) |
| 计数 | count | 获取符合条件的记录条数 |
| 读 | get | 获取数据表中的记录,如果有使用 where 语句定义查询条件,则会返回匹配结果集 (触发请求) |
| 引用 | doc | 获取对该数据表中指定 id 的记录的引用 |
| 查询条件 | where | 通过指定条件筛选出匹配的记录,可搭配查询指令(eq, gt, in, ...)使用 |
| skip | 跳过指定数量的文档,常用于分页,传入 offset。clientDB组件有封装好的更易用的分页,另见 | |
| orderBy | 排序方式 | |
| limit | 返回的结果集(文档数量)的限制,有默认值和上限值 | |
| field | 指定需要返回的字段 |
collection对象的方法可以增和查数据,删和改不能直接操作,需要collection对象通过doc或get得到指定的记录后再调用remove或update方法进行删改。
数据操作的API较多,请单独参考文档:
示例
这里我们使用clientDB,实现一个简单的在前端获取刚才输入 resume 表的记录的功能。
<template>
	<view class="content">
		<button @click="testclientdb()">请求数据库</button>
	</view>
</template>
<script>
	export default {
		data() {
			return {}
		},
		methods: {
			testclientdb() {
				const db = uniCloud.database();
				db.collection("resume").get().then((res) => {
					// res 为数据库查询结果
					console.log(res)
				}).catch((e) => {
					console.log(e)
				});
			}
		}
	}
</script>
res.result.data下即为数据表 resume 中的数据。数据库内数据类型有以下几种:
DB Schema的数据类型有专门文档,详见
Date 类型用于表示时间,精确到毫秒,可以用 JavaScript 内置 Date 对象创建。需要特别注意的是,连接本地云函数时,用此方法创建的时间是客户端当前时间,不是服务端当前时间,只有连接云端云函数才是服务端当前时间。
另外,我们还单独提供了一个 API 来创建服务端当前时间,使用 serverDate 对象来创建一个服务端当前时间的标记,该对象暂时只支持腾讯云空间,当使用了 serverDate 对象的请求抵达服务端处理时,该字段会被转换成服务端当前的时间,更棒的是,我们在构造 serverDate 对象时还可通过传入一个有 offset 字段的对象来标记一个与当前服务端时间偏移 offset 毫秒的时间,这样我们就可以达到比如如下效果:指定一个字段为服务端时间往后一个小时。
// 服务端当前时间
new db.serverDate()
// 在云函数内使用new Date()和new db.serverDate()效果一样
//服务端当前时间加1S
new db.serverDate({
  offset: 1000
})
// 在云函数内使用new Date(Date.now() + 1000)和上面的用法效果一样
用于表示地理位置点,用经纬度唯一标记一个点,这是一个特殊的数据存储类型。
签名:Point(longitude: number, latitude: number)
示例:
new db.Geo.Point(longitude, latitude)
用于表示地理路径,是由两个或者更多的 Point 组成的线段。
签名:LineString(points: Point[])
示例:
new db.Geo.LineString([
  new db.Geo.Point(lngA, latA),
  new db.Geo.Point(lngB, latB),
  // ...
])
用于表示地理上的一个多边形(有洞或无洞均可),它是由一个或多个闭环 LineString 组成的几何图形。
由一个环组成的 Polygon 是没有洞的多边形,由多个环组成的是有洞的多边形。对由多个环(LineString)组成的多边形(Polygon),第一个环是外环,所有其他环是内环(洞)。
签名:Polygon(lines: LineString[])
示例:
new db.Geo.Polygon([
  new db.Geo.LineString(...),
  new db.Geo.LineString(...),
  // ...
])
用于表示多个点 Point 的集合。
签名:MultiPoint(points: Point[])
示例:
new db.Geo.MultiPoint([
  new db.Geo.Point(lngA, latA),
  new db.Geo.Point(lngB, latB),
  // ...
])
用于表示多个地理路径 LineString 的集合。
签名:MultiLineString(lines: LineString[])
示例:
new db.Geo.MultiLineString([
  new db.Geo.LineString(...),
  new db.Geo.LineString(...),
  // ...
])
用于表示多个地理多边形 Polygon 的集合。
签名:MultiPolygon(polygons: Polygon[])
示例:
new db.Geo.MultiPolygon([
  new db.Geo.Polygon(...),
  new db.Geo.Polygon(...),
  // ...
])
不同于传统开发,连接数据库有单次操作时长限制,目前单次操作时间限制如下。超出此时间会报超时错误。一般情况下在设置了合适的索引时不会遇到超时错误,如何优化查询速度请参考:数据库性能优化
| 腾讯云 | 阿里云 | 支付宝云 |
|---|---|---|
| 5秒 | 5秒 | 默认5秒;最大5分钟 |
如果是大数据批处理,可以参考云函数递归调用,连续执行多个云函数处理一个任务详情查看
uniCloud数据库提供了多种数据导入导出和备份方案。
HBuilderX 3.97起支持常用于插件市场的插件做环境初始化。完整支持数据、索引、schema三部分。不适合处理大量数据,操作可能超时。可从uniCloud web控制台云数据库 => 生成初始化数据 导出。除上述三种方法外,开发者还可以编程处理数据的导入导出。如进行大量数据操作,建议在HBuilderX的本地运行云函数环境中操作,这样可以避免触发云端的云函数超时限制。
下面对三种方法的使用方式进行详细说明:
HBuilderX 3.97起支持
旧规范中的db_init.json废弃,但是仍保留db_init.json上的初始化菜单,对db_init.json文件执行初始化操作时,其中的初始化数据、索引、schema会被拆分成多个文件。
注意
此方式导入导出会消耗数据库读写次数,不适用于大数据量导入导出,仅适用于项目初始化。
HBuilderX 3.97及以上版本,uniCloud内database目录支持直接右键进行数据库初始化。database目录下支持以下几种文件类型
在执行数据库初始化操作时,上述文件都会被上传到云端。
web控制台导出时默认不包括_id字段,在导入时,数据库插入新记录时会自动补_id字段。如果需要指定_id,需要手工补足数据。
在db_init.json内可以使用以下形式定义Date类型的数据:
{
  "dateObj": { // dateObj字段就是日期类型的数据
    "$date": "2020-12-12T00:00:00.000Z" // ISO标准日期字符串
  }
}
注意下面的示例仅为演示,实际配置时不要带注释
// 表名.index.json
[{ // 索引列表
"IndexName": "index_a", // 索引名称
"MgoKeySchema": { // 索引规则
"MgoIndexKeys": [{
"Name": "index", // 索引字段
"Direction": "1" // 索引方向,1:ASC-升序,-1:DESC-降序,2dsphere:地理位置
}],
"MgoIsUnique": false, // 索引是否唯一
"MgoIsSparse": false // 是否为稀疏索引,请参考 https://doc.dcloud.net.cn/uniCloud/db-index?id=sparse
}
}]
db_init.json初始化数据库HBuilderX 3.97及之后版本需要拆分为上面一种方式对应的文件,可以在项目管理器选中db_init.json右键初始化数据库时自动拆分。
注意
此方式导入导出会消耗数据库读写次数,不适用于大数据量导入导出,仅适用于项目初始化。
db_init.json定义了一个json格式,里面包含了表名、表数据、表索引等表的相关数据。
在HBuilderX中,项目的cloudfunctions目录(HBuilderX 2.5.11 - 2.9.11版本) 或 uniCloud/database 目录(HBuilderX 3.0+版本),可以放置db_init.json文件,对该文件点右键,可以按db_init.json的描述,在云服务空间创建相应的表、初始化表中的数据、索引和schema。
这个功能尤其适合插件作者,可以快速初始化插件所需的数据库环境。
db_init.json的数据格式
db_init.json包含三部分:数据内容(data)、数据表索引(index)、数据表结构(schema),形式如下
注意:HBuilderX 3.0.0以上版本schema不再放在db_init.json内,而是独立放在uniCloud/database/目录下。
详细调整如下:
cloudfunctions/db_init.json移至uniCloud/database/db_init.jsonuniCloud/database/news.schema.jsonuniCloud/database目录上右键创建db_init.json文件右键初始化云数据库时依然会带上schema进行数据库的初始化,除schema外HBuilderX3.0.0以上版本使用db_init.json初始化数据库还会带上扩展校验函数,扩展校验函数位于uniCloud/database/validateFunction目录下,扩展校验函数文档详见:validateFunctionHBuilderX 3.0.0版本之前的db_init.json示例
{
"collection_test": { // 集合(表名)
"data": [ // 数据
{
"_id": "da51bd8c5e37ac14099ea43a2505a1a5", // 一般不带_id字段,防止导入时数据冲突。
"name": "tom"
}
],
"index": [{ // 索引
"IndexName": "index_a", // 索引名称
"MgoKeySchema": { // 索引规则
"MgoIndexKeys": [{
"Name": "index", // 索引字段
"Direction": "1" // 索引方向,1:ASC-升序,-1:DESC-降序,2dsphere:地理位置
}],
"MgoIsUnique": false, // 索引是否唯一
"MgoIsSparse": false // 是否为稀疏索引,请参考 https://doc.dcloud.net.cn/uniCloud/db-index?id=sparse
}
}],
"schema": { // HBuilderX 3.0.0以上版本schema不在此处,而是放在database目录下单独的`表名.schema.json`文件内
"bsonType": "object",
"permission": {
".read": true,
".create": false,
".update": false,
".delete": false
},
"required": [
"image_url"
],
"properties": {
"_id": {
"description": "ID,系统自动生成"
},
"image_url": {
"bsonType": "string",
"description": "可以是在线地址,也支持本地地址",
"label": "图片url"
}
}
}
}
}
在HBuilderX中对上述db_init.json点右键,可初始化数据库到云服务空间,创建collection_test表,并按上述json配置设置该表的index索引和schema,以及插入data下的数据。
opendb的表,在db_init.json中初始化时,不建议自定义index和schema。系统会自动从opendb规范中读取最新的index和schema。
使用db_init.json导入数据库
在HBuilderX中,对项目下的cloudfunctions目录下的db_init.json点右键,即可选择初始化云数据库。将db_init.json里的内容导入云端。
注意事项:
db_init.json为同步导入形式,无法导入大量数据。导入大量数据请使用web控制台的数据库的导入功能。db_init.json中的表名与opendb中任意表名相同,且db_init.json中该表名内没有编写schema和index,则在初始化时会自动拉取最新的opendb规范内对应表的schema和index。db_init.json中的数据表在服务空间已存在,且db_init.json中该表含有schema和index,则在初始化时schema会被替换,新增索引会被添加,已存在索引不受影响。生成db_init.json的方式
在uniCloud web控制台的数据库界面,左侧导航点击 生成db_init.json,会将选择的表的内容、索引、表结构导出为db_init.json文件。
注意事项:
_id字段,在导入时,数据库插入新记录时会自动补_id字段。如果需要指定_id,需要手工补足数据。在db_init.json内可以使用以下形式定义Date类型的数据:
{
  "dateObj": { // dateObj字段就是日期类型的数据
    "$date": "2020-12-12T00:00:00.000Z" // ISO标准日期字符串
  }
}
uniCloud会在每天凌晨自动备份一次数据库,最多保留7天。这让开发者不再担心数据丢失。
操作说明
云数据库 --> 数据库回档,点击新建回档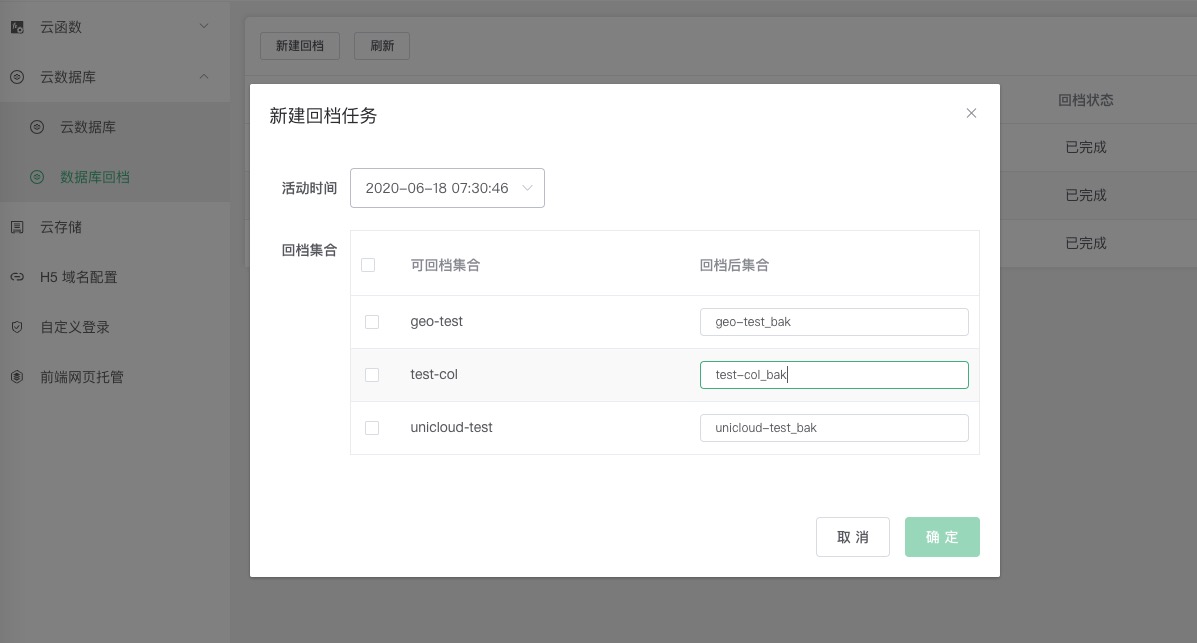
此功能主要用于导出整个表的数据,导出文件.json后缀的文件,内容为jsonl格式。
jsonl格式示例,形如下面这样每行一个json格式的数据库记录的文件
{"a":1}
{"a":2}
用法
cloudfunctions上右键打开uniCloud web控制台注意
_id, name, age, gender数据导入功能可以导入大量数据,目前支持导入 CSV、JSON 格式(推荐使用该格式)的文件数据。
JSON格式的文件后缀为.json,文件内容为jsonl格式。该内容格式与导出时的文件内容格式对应,如果担心自己生成的内容有问题或不确定具体格式,可操作导出一张有较少数据的表来确认格式。
jsonl格式示例,形如下面这样每行一个json格式的数据库记录的文件
{"a":1}
{"a":2}
用法
cloudfunctions上右键打开uniCloud web控制台注意
insert表示冲突时依旧导入记录,此时会由于_id冲突报错。upsert表示冲突时更新已存在的记录。如果是自己拼接的json格式数据请注意:如果存在表A关联表B的字段的场景需要保证关联字段在A、B内是一致的(特别需要注意的是各种与_id关联的字段)
例: 正确示例
// 每一行插入一个标准的 json 数据,不要用逗号分隔
{"title":"日常寒暄与社交","type":"main","parent_id":"","level":0}
{"title":"购物与消费","type":"main","parent_id":"","level":0}
{"title":"餐饮与美食","type":"main","parent_id":"","level":0}
{"title":"休闲娱乐活动","type":"main","parent_id":"","level":0}
正确示例
// 这里为了方便看数据进行了格式化,实际导入所需的json文件是每行一条记录
// article表
{
  "user_id": {
    $oid: "601cf1dbf194b200018ed8ec"
  }
}
// user表
{
  "_id": {
    $oid: "601cf1dbf194b200018ed8ec"
  }
}
错误示例
// 这里为了方便看数据进行了格式化,实际导入所需的json文件是每行一条记录
// article表
{
  "user_id": "601cf1dbf194b200018ed8ec"
}
// user表
{
  "_id": {
    $oid: "601cf1dbf194b200018ed8ec"
  }
}
文档移至:在云厂商之间迁移数据库